完整路线:参考、故事、渲染
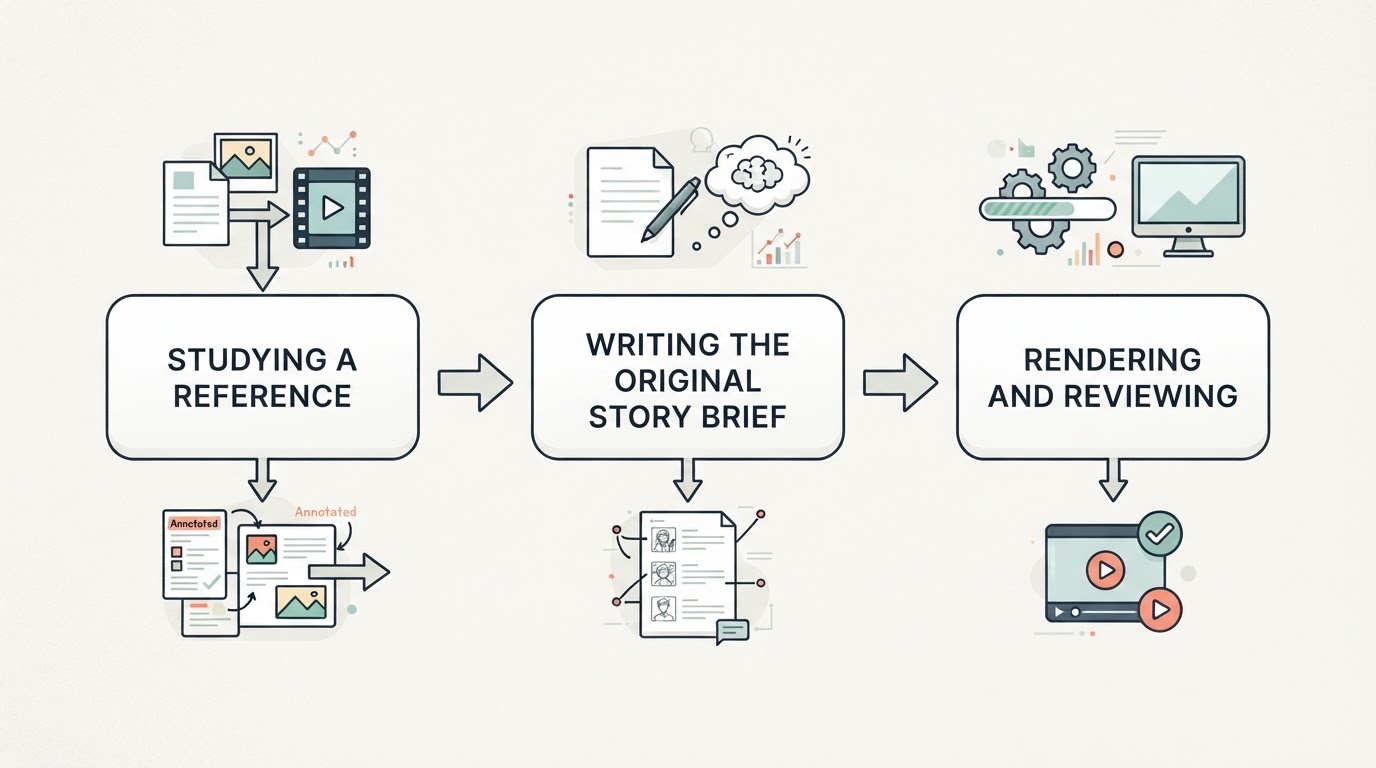
大多数建议从提示词输入框讲起。那跳过了决定结果是否属于你的两个判断:你从参考里学到了什么,以及你想讲的是什么故事。一条可行的路线有四步,每一步对应一份产物:
阶段 | 你带来什么 | 你带走什么 |
|---|---|---|
研究一条参考 | 一条你有权研究的短视频 | 节拍大纲:开头、镜头顺序、时序 |
写原创故事 | 目标、素材、你自己的请求文本 | 故事文本加镜头级简报 |
准备输入 | 参考、故事文本、视觉风格 | 一份你已审阅、含费用的请求 |
渲染与审片 | 一个已提交的后台任务 | 一份已接受或退回的成品文件 |
这条链路有两处接缝。跳过简报,你最终是在给一种情绪写提示词,而不是给一个故事。跳过审片,你发布出去的成片,字幕描述的是素材里从未出现过的场景。结构先行,然后是决策,最后是检查——按这个顺序。
把参考读三遍
参考视频要到你不用回放就能描述它的程度才有用。三遍观察能到那里,每遍产出一种不同的笔记。
第一遍,看开头。 静音看完前两三秒,写下在任何人开口之前画面里已经有的东西:画框、主体、承诺。问自己开头埋下了什么问题,因为整条视频回答的就是这个问题。说不出这个问题,开头就只是装饰,没有起作用。
第二遍,看镜头顺序。 再放一遍,按顺序列出每个镜头,一行一个,格式是「镜头,它揭示了什么」。这份列表是你以后会复用的骨架。你记录的是信息的顺序,不是画面本身:两个铺垫镜头之后来一个揭示,是结构选择,换到完全不同的场景也能这么做。
第三遍,看节奏。 开着计时器放第三遍,给节拍标上时间码:0:00 钩子、0:12 冲突、1:14 回报。同一结构的 45 秒版本可能写成:0:00 一张图讲清问题,0:12 失败的尝试,0:38 解决问题的结果。带时间码的节拍,是不带走一帧画面也能带进原创视频的参考部分。之后你按时间段描述自己的镜头序列时,借的是节奏——节奏是原理,不是所有权。
参考视频给不了你什么
找到一条视频不等于获得使用许可。美国版权局说明,使用他人的作品一般需要获得版权所有者的许可,而且没有任何法律规则允许固定的字数、音符或作品百分比,所以「我只用了几秒」并不是稳妥的假设。它还指出,某次使用是否算合理使用,取决于所有具体情况。(美国版权局)
同一页面还堵上了人们接下来想钻的口子:只有版权所有者才能授权作品的衍生版本,所以无论你改动多少,都不能在他人作品上主张版权,除非所有者同意;使用存疑时,版权局建议先取得许可。
实际操作上,这意味着改动任何东西之前先问三个独立问题:你是否有权使用这段素材、是否有权使用这段音乐、以及出镜的人是否给了许可。热门片段一个都回答不了。研究结构,把录屏留作调研材料,画面自己拍。
先重写原则,再描述镜头
简报不是字数更多的提示词。它是让另一个人——或另一个模型——复现你意图的文档。三个部分让它可用。
目标。 一句话写清观众看完应该知道什么、感受到什么、做什么。「一条 40 秒的解释视频,让价格异议显得已被回答」是目标。「一条很酷的 AI 视频」不是目标,提示词再怎么打磨也补不回缺失的目标。
素材。 你实际拥有的东西:关于产品的已确认事实、地点、场景、你提炼的节拍大纲,以及每项背后的授权。素材是一份约束清单,先写下来,模型才不会替你发明其余部分。
请求。 用你自己的话写镜头级文本,带上节拍和各自时长,再加上渲染回来后你要检查的审片点。如果你说不清什么情况会让你否掉结果,这份简报还没写完。
把大纲转成执行指令
模型厂商会记录真正影响镜头效果的决策项。Google DeepMind 的 Veo 模型指南建议明确镜头取景与运镜、视觉风格、灯光、具体的角色描述、地点、动作与对白,并构建有清晰开端、中段和结局的叙事。(Google DeepMind)Google Cloud 把这些浓缩成一个五要素公式——镜头语言、主体、动作、语境、带氛围的风格——并介绍了时间戳提示词:把动作分配到一次生成内的不同时间段,让多镜头序列保持节奏。(Google Cloud)
把它们当决策清单用,而不是当咒语。不同生成器解析不同的语法,为某家模型记录的公式不是所有工具的通用标准。真正跨工具有效的是纪律:取景、主体、动作、语境、风格和时序,每一项都是你有意做出的选择,而不是丢给模型。
让第一稿保持诚实
重写这一步决定参考变成衍生品还是原创。换掉场景、角色、具体物件和结局;保留信息的顺序和节奏。把你的简报逐帧描述出来,如果看起来还像参考,那你就是在抄而不是改编,视频末尾加免责声明也救不回来。
准备、渲染、审片:三道关卡
从简报到可发布文件之间隔着三道关卡。每道都有通过条件,而且越往后失败的成本越高。
第一道:输入完整
Meltica 有两条创作路径。商家可以从一份书面请求开始并补充品牌细节作为背景,或从三天日历里选一个想法。个人创作者从素材库选择参考视频或上传视频,加入自己的想法并选择风格。确认简报后,AI 开始生成。(Meltica)提交前先核对你所选工作流要求的输入。个人创作必须有参考视频;商家可以从文本开始。
第二道:渲染在后台运行
生成不是即时的。按长度和镜头数不同,任务通常运行 10 到 30 分钟,你关掉页面它也继续跑,所以正确做法是提交一次、记下任务、重新提交前先查状态。同一个不明确的任务提交两次,就是一个想法付两次钱。
第三道:审片是真工作
把简报摊在旁边,完整看一遍结果,按顺序检查四件事:故事是否按计划的形状落地、字幕是否与画面一致、声音是否承载节拍、有没有混入你不打算展示的细节——没布完的景、没授权的 logo、从画面边上伸进来的手。审片是合格条件,不是走过场。
知道工具不承诺什么
即使参考很好、简报很精确,复刻也不是复制。在 Meltica 基于参考的工作流里,请审片后再用,不要预设结果会与参考的对白、镜头顺序、时长或视觉细节一致。(Meltica)复用风格时检查连续性;角色与声音的一致不做保证。产品图片和产品实拍素材的直接生成,目前在商家和个人工作流中都不可用。发布前完整看一遍视频;如果任务失败,先查任务记录再判断是否扣费或重新提交。
参考用来学,故事归自己,审片后再发布
整个方法就是三个节拍:把参考研究到能描述其结构的程度,写故事让结构变成你的,再对照你写的故事审片,而不是对照你佩服的那条参考。
带出门的习惯比工具更小。参考是老师,不是模板。学会时序,写你自己的节拍,你发布出去的视频就是你能讲清来龙去脉的视频。